64GBのMacで試すローカルLLMを選ぶとき、モデル名やスコアだけでは候補を絞りきれません。まず確認したいのは、任せたい作業・必要な入力・量子化した重みの規模です。
このページでは、24モデルの比較資料をもとに、基本情報・量子化別容量・公開ベンチマークを切り替えて見比べられるように整理しました。M1 Max・64GBを参考環境とし、導入前の候補選びに使えます。
【未検証】全24モデルのMac実機動作・実使用RAM・生成速度・量子化後の品質は検証していません。容量は資料の基準パラメータ数による計算値、ベンチマークは公開値、用途は【提案】として区別しています。
資料整理・主要な公式出典の確認日:2026年10月26日。モデルの提供状況や利用条件は変更されるため、導入時に各行の出典も確認してください。
ローカルLLM 24モデルを比較する
「基本情報」で用途と対応入力を見て、「量子化別容量」で重みの規模を確認し、「公開ベンチマーク」で評価の出典と条件をたどります。気になるモデルの「比較する」にチェックを入れると、選択したモデルだけを表示できます。
元の比較表を手元で確認したい場合は、PDF版もご利用ください。記事内の番号はPDFと共通です。
24 MODELS / PDFと同じ番号で比較
まずは基本情報で用途を絞り、容量と公開評価を見比べてください。モデル名から公式資料、公開評価の表から評価の出典を開けます。
【未検証】全24モデルのMac実機動作・速度・実使用RAMは検証していません。容量は重みだけの理論値、用途は候補の提案です。
比べたいモデルの「比較する」にチェックを入れると、選択したモデルだけを表示できます。項目を切り替えても選択は引き継がれます。
24モデルを表示・0モデル選択中
表は縦・横にスクロールできます。見出しと左端のモデル名は固定表示です。
条件に合うモデルがありません。検索語やシリーズ、選択モデルの条件を見直してください。
基本情報・用途候補
文=テキスト、画=画像、音=音声。動画入力の処理条件は各モデルの公式資料で確認してください。最大コンテキストは64GBのMacで使える長さを保証しません。
| モデル・出典 | 構造・規模 | 対応入力 | コンテキスト | 用途候補【提案】 | 配布・条件 |
|---|---|---|---|---|---|
| PDF No.01Gemma 4 31B(新しいタブ) | Dense / 31B級・言語30.7B画像encoder別 | 文・画・動画 | 256K tokens | SEO記事・分析【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.02Gemma 4 26B A4B(新しいタブ) | MoE / 26B級・言語25.2B稼働3.8B・画像encoder別 | 文・画・動画 | 256K tokens | コード補助・文章【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.03Gemma 4 12B Unified(新しいタブ) | Dense / 11.95B | 文・画・音・動画 | 256K tokens | 軽量処理・文章【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.04Gemma 2 27B(新しいタブ) | Dense / 27B級ベンチはPT版・対話版と別 | 文 | 8,192 tokens | 文章生成・比較用【提案】実務品質は未検証 | 公開重み / Gemma規約 |
| PDF No.05Qwen3.8-27B(新しいタブ) | Dense / 言語27B画像部・MTP等は別 | 文・画・動画 | 262,144 / 拡張1,000,000 tokens | コーディング・SEO【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.06Qwen3.6-35B-A3B(新しいタブ) | MoE / 言語35B/稼働3B画像部・MTP等は別 | 文・画・動画 | 262,144 / 拡張1,010,000 tokens | AIエージェント・分析【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.07Qwen3-Coder-30B-A3B-Instruct(新しいタブ) | MoE / 総30.5B/稼働3.3BNon-thinking | 文 | 262,144 / 拡張1,000,000 tokens | WordPress・PHP・JS【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.08Flash-NextQwen3.8-Flash-Next(新しいタブ) | MoE / 125B+51B+4B稼働6B/埋込51B・MTP4B | 文・画・動画 | 262,144 / 拡張1,000,000 tokens | 高度な推論・自動化【提案】実務品質は未検証 | 公開重み / Qwen Community 1.0 |
| PDF No.09DeepSeek-R1-Distill-Qwen-32B(新しいタブ) | Dense / 32B級 | 文 | 131,072 / 配布config上限 tokens | 推論・問題解決【提案】実務品質は未検証 | 公開重み / MIT |
| PDF No.10Llama 4 Scout 17B-16E Instruct(新しいタブ) | MoE / 総109B/稼働17B16 experts | 文・画 | 10M tokens | 長文処理・分析【提案】実務品質は未検証 | 公開重み / Llama 4規約 |
| PDF No.11参考項目Mistral Medium 3(新しいタブ) | 要確認 / 【要確認】非推奨化 2026-05-22 | マルチモーダル | 128K tokens | 汎用・文章生成【提案】実務品質は未検証 | 一般公開重み未確認 / 契約条件要確認 |
| PDF No.12Gemma 4 E2B(新しいタブ) | Dense / 言語5.1B/有効2.3B画像・音声encoder別 | 文・画・音・動画 | 128K tokens | 短文・音声入力の試作【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.13Gemma 4 E4B(新しいタブ) | Dense / 言語8B/有効4.5B画像・音声encoder別 | 文・画・音・動画 | 128K tokens | 軽量な要約・音声入力【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.14Qwen3.5-0.8B(新しいタブ) | Dense / 言語0.8B画像部・MTP等は別 | 文・画・動画 | 262,144 tokens | 小規模な分類・抽出の試作【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.15Qwen3.5-2B(新しいタブ) | Dense / 言語2B画像部・MTP等は別 | 文・画・動画 | 262,144 tokens | 定型文・分類・要約の試作【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.16Qwen3.5-4B(新しいタブ) | Dense / 言語4B画像部・MTP等は別 | 文・画・動画 | 262,144 / 拡張1,010,000 tokens | 軽量な文章・画像分析【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.17Qwen3.5-9B(新しいタブ) | Dense / 言語9B画像部・MTP等は別 | 文・画・動画 | 262,144 / 拡張1,010,000 tokens | 文章・画像・コードの試作【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.18Qwen3.6-27B(新しいタブ) | Dense / 言語27B画像部・MTP等は別 | 文・画・動画 | 262,144 / 拡張1,010,000 tokens | コード・分析の比較用【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.19Qwen3.5-122B-A10B(新しいタブ) | MoE / 言語122B/稼働10B画像部・MTP等は別 | 文・画・動画 | 262,144 / 拡張1,010,000 tokens | 大型モデルの分析比較【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.20Qwen3-Next-80B-A3B-Thinking(新しいタブ) | MoE / 総80B/稼働3BFlash-Nextとは別モデル | 文 | 262,144 / 拡張1,010,000 tokens | 複雑な推論・長文の比較【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.21Qwen3-Coder-Next(新しいタブ) | MoE / 総80B/稼働3B下欄に量子化別の外部実測 | 文 | 262,144 tokens | コード修正・開発支援【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.22DeepSeek-R1-Distill-Qwen-14B(新しいタブ) | Dense / 14B級 | 文 | 131,072 / 配布config上限 tokens | 推論・数学の軽量比較【提案】実務品質は未検証 | 公開重み / MIT |
| PDF No.23Mistral Small 3.2 24B Instruct(新しいタブ) | Dense / 24B級 | 文・画 | 128K tokens | 文章・画像・構造化出力【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
| PDF No.24Mistral Small 4 119B A6B(新しいタブ) | MoE / 総119B/稼働6.5BGPQAはHF評価欄 [HF] | 文・画 | 256K tokens | 大型の推論・開発比較【提案】実務品質は未検証 | 公開重み / Apache 2.0 |
No.11は一般公開重み未確認の参考項目です。「公開重み」の表記も、すべての量子化形式の配布やMacでの実行を保証するものではありません。
量子化別の重み理論容量
単位はGB(10進)。実使用RAM・配布ファイルの容量ではありません。基準パラメータ数(10億)× bit ÷ 8で算出し、小数1桁に丸めています。MoEも総パラメータ数を基準に計算しています。
| モデル・出典 | 2bit | 3bit | 4bit | 5bit | 6bit | 8bit | FP16 BF16 |
|---|---|---|---|---|---|---|---|
| PDF No.01Gemma 4 31B(新しいタブ) | 7.7 | 11.5 | 15.4 | 19.2 | 23.0 | 30.7 | 61.4 |
| PDF No.02Gemma 4 26B A4B(新しいタブ) | 6.3 | 9.5 | 12.6 | 15.8 | 18.9 | 25.2 | 50.4 |
| PDF No.03Gemma 4 12B Unified(新しいタブ) | 3.0 | 4.5 | 6.0 | 7.5 | 9.0 | 12.0 | 23.9 |
| PDF No.04Gemma 2 27B(新しいタブ) | 6.8 | 10.1 | 13.5 | 16.9 | 20.3 | 27.0 | 54.0 |
| PDF No.05Qwen3.8-27B(新しいタブ) | 6.8 | 10.1 | 13.5 | 16.9 | 20.3 | 27.0 | 54.0 |
| PDF No.06Qwen3.6-35B-A3B(新しいタブ) | 8.8 | 13.1 | 17.5 | 21.9 | 26.3 | 35.0 | 70.064GB以上 |
| PDF No.07Qwen3-Coder-30B-A3B-Instruct(新しいタブ) | 7.6 | 11.4 | 15.3 | 19.1 | 22.9 | 30.5 | 61.0 |
| PDF No.08Flash-NextQwen3.8-Flash-Next(新しいタブ) | 45.0 | 67.564GB以上 | 90.064GB以上 | 112.564GB以上 | 135.064GB以上 | 180.064GB以上 | 360.064GB以上 |
| PDF No.09DeepSeek-R1-Distill-Qwen-32B(新しいタブ) | 8.0 | 12.0 | 16.0 | 20.0 | 24.0 | 32.0 | 64.064GB以上 |
| PDF No.10Llama 4 Scout 17B-16E Instruct(新しいタブ) | 27.3 | 40.9 | 54.5 | 68.164GB以上 | 81.864GB以上 | 109.064GB以上 | 218.064GB以上 |
| PDF No.11参考項目Mistral Medium 3(新しいタブ) | 未確認 | 未確認 | 未確認 | 未確認 | 未確認 | 未確認 | 未確認 |
| PDF No.12Gemma 4 E2B(新しいタブ) | 1.3 | 1.9 | 2.6 | 3.2 | 3.8 | 5.1 | 10.2 |
| PDF No.13Gemma 4 E4B(新しいタブ) | 2.0 | 3.0 | 4.0 | 5.0 | 6.0 | 8.0 | 16.0 |
| PDF No.14Qwen3.5-0.8B(新しいタブ) | 0.2 | 0.3 | 0.4 | 0.5 | 0.6 | 0.8 | 1.6 |
| PDF No.15Qwen3.5-2B(新しいタブ) | 0.5 | 0.8 | 1.0 | 1.3 | 1.5 | 2.0 | 4.0 |
| PDF No.16Qwen3.5-4B(新しいタブ) | 1.0 | 1.5 | 2.0 | 2.5 | 3.0 | 4.0 | 8.0 |
| PDF No.17Qwen3.5-9B(新しいタブ) | 2.3 | 3.4 | 4.5 | 5.6 | 6.8 | 9.0 | 18.0 |
| PDF No.18Qwen3.6-27B(新しいタブ) | 6.8 | 10.1 | 13.5 | 16.9 | 20.3 | 27.0 | 54.0 |
| PDF No.19Qwen3.5-122B-A10B(新しいタブ) | 30.5 | 45.8 | 61.0 | 76.364GB以上 | 91.564GB以上 | 122.064GB以上 | 244.064GB以上 |
| PDF No.20Qwen3-Next-80B-A3B-Thinking(新しいタブ) | 20.0 | 30.0 | 40.0 | 50.0 | 60.0 | 80.064GB以上 | 160.064GB以上 |
| PDF No.21Qwen3-Coder-Next(新しいタブ) | 20.0 | 30.0 | 40.0 | 50.0 | 60.0 | 80.064GB以上 | 160.064GB以上 |
| PDF No.22DeepSeek-R1-Distill-Qwen-14B(新しいタブ) | 3.5 | 5.3 | 7.0 | 8.8 | 10.5 | 14.0 | 28.0 |
| PDF No.23Mistral Small 3.2 24B Instruct(新しいタブ) | 6.0 | 9.0 | 12.0 | 15.0 | 18.0 | 24.0 | 48.0 |
| PDF No.24Mistral Small 4 119B A6B(新しいタブ) | 29.8 | 44.6 | 59.5 | 74.464GB以上 | 89.364GB以上 | 119.064GB以上 | 238.064GB以上 |
64GB以上は重みの理論容量だけで64GB以上になる欄です。64GB未満の欄も動作可能の判定ではありません。量子化の補助情報、未量子化層、画像・音声部、KVキャッシュ、一時領域、macOSなどが別途必要です。各bit形式の配布・エンジン対応は未確認です。
No.08の計算基準は125B+埋め込み51B+MTP4B=180Bです。稼働6Bを使った計算ではありません。
公開ベンチマーク
公開資料に掲載された評価値で、Mac実機や量子化後の成績ではありません。提供元ごとの評価条件は統一していません。GPQA DiamondとLiveCodeBench v6は別の評価で、異なる指標同士を順位づけしていません。
| モデル・出典 | GPQA Diamond 科学的推論・% | LiveCodeBench v6 コード課題・% | その他の指標 名称・条件を区別 | 評価の出典 |
|---|---|---|---|---|
| PDF No.01Gemma 4 31B(新しいタブ) | 84.3 | 80 | MMLU-Pro 85.2公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.02Gemma 4 26B A4B(新しいタブ) | 82.3 | 77.1 | MMLU-Pro 82.6公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.03Gemma 4 12B Unified(新しいタブ) | 78.8 | 72 | MMLU-Pro 77.2公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.04Gemma 2 27B(新しいタブ) | 未確認 | 未確認 | MMLU 75.2 [PT]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 MMLU 75.2は事前学習版(PT)の5-shot top-1です。対話版やMMLU-Proとは別指標です。GPQA Diamond・LiveCodeBench v6は未確認です。 | 評価の出典(新しいタブ) |
| PDF No.05Qwen3.8-27B(新しいタブ) | 89.2 | 90.3 | SWE-Pro 61.7公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.06Qwen3.6-35B-A3B(新しいタブ) | 86 | 80.4 | MMLU-Pro 85.2公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 ベンチマーク出典は公式Qwen3.6-27Bモデルカード内のQwen3.6-35B-A3B列です。 | 評価の出典(新しいタブ) |
| PDF No.07Qwen3-Coder-30B-A3B-Instruct(新しいタブ) | 未確認 | 未確認 | 未確認公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 GPQA Diamond・LiveCodeBench v6の該当値は今回未確認です。 | 評価の出典(新しいタブ) |
| PDF No.08Flash-NextQwen3.8-Flash-Next(新しいタブ) | 91.7 | 91.9 | SWE-Pro 62.5公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.09DeepSeek-R1-Distill-Qwen-32B(新しいタブ) | 62.1 | 未確認 | LCB 57.2 [版不明]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 GPQA Diamondはpass@1。その他欄のLiveCodeBench 57.2は版不明で、LiveCodeBench v6列には入れていません。 | 評価の出典(新しいタブ) |
| PDF No.10Llama 4 Scout 17B-16E Instruct(新しいタブ) | 57.2 | 未確認 | MMLU-Pro 74.3公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 GPQA Diamond 57.2は公式モデルカード本文のinstruction-tuned/BF16・0-shot accuracyです。HF評価欄の別結果46.46と区別しています。LiveCodeBench v6は未確認です。 | 評価の出典(新しいタブ) |
| PDF No.11参考項目Mistral Medium 3(新しいタブ) | 未確認 | 未確認 | 未確認公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 一般公開重み未確認の参考項目です。主なベンチマークは今回未確認です。 | 評価の出典(新しいタブ) |
| PDF No.12Gemma 4 E2B(新しいタブ) | 43.4 | 44 | MMLU-Pro 60.0公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.13Gemma 4 E4B(新しいタブ) | 58.6 | 52 | MMLU-Pro 69.4公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.14Qwen3.5-0.8B(新しいタブ) | 未確認 | 未確認 | MMLU-Pro 42.3 [T]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 MMLU-Pro 42.3はThinkingモード。公式表にはGPQAの値がありますがDiamond表記を確認できないため、GPQA Diamond列は未確認としています。LiveCodeBench v6も未確認です。 | 評価の出典(新しいタブ) |
| PDF No.15Qwen3.5-2B(新しいタブ) | 未確認 | 未確認 | MMLU-Pro 66.5 [T]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 MMLU-Pro 66.5はThinkingモード。公式表にはGPQAの値がありますがDiamond表記を確認できないため、GPQA Diamond列は未確認としています。LiveCodeBench v6も未確認です。 | 評価の出典(新しいタブ) |
| PDF No.16Qwen3.5-4B(新しいタブ) | 76.2 | 55.8 | MMLU-Pro 79.1公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.17Qwen3.5-9B(新しいタブ) | 81.7 | 65.6 | MMLU-Pro 82.5公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.18Qwen3.6-27B(新しいタブ) | 87.8 | 83.9 | MMLU-Pro 86.2公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.19Qwen3.5-122B-A10B(新しいタブ) | 86.6 | 78.9 | MMLU-Pro 86.7公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 | 評価の出典(新しいタブ) |
| PDF No.20Qwen3-Next-80B-A3B-Thinking(新しいタブ) | 77.2 | 68.7 | MMLU-Pro 82.7公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 ベンチマーク出典は公式Qwen3.5-9Bモデルカード内のQwen3-Next-80B-A3B-Thinking列です。 | 評価の出典(新しいタブ) |
| PDF No.21Qwen3-Coder-Next(新しいタブ) | 未確認 | 未確認 | SWE-v 70.6 [HF]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 SWE-bench Verified 70.6はHF評価欄の値です。SWE-bench Proとは別指標です。GPQA Diamond・LiveCodeBench v6は今回未確認です。 | 評価の出典(新しいタブ) |
| PDF No.22DeepSeek-R1-Distill-Qwen-14B(新しいタブ) | 59.1 | 未確認 | LCB 53.1 [版不明]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 GPQA Diamondはpass@1。その他欄のLiveCodeBench 53.1は版不明で、LiveCodeBench v6列には入れていません。 | 評価の出典(新しいタブ) |
| PDF No.23Mistral Small 3.2 24B Instruct(新しいタブ) | 46.13 | 未確認 | MMLU-Pro 69.06 [5s]公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 GPQA Diamond 46.13とMMLU-Pro 69.06は5-shot CoTの値です。LiveCodeBench v6は未確認です。 | 評価の出典(新しいタブ) |
| PDF No.24Mistral Small 4 119B A6B(新しいタブ) | 71.2 | 未確認 | AA-LCR 0.72公開資料の評価値です。量子化後・Mac実機の成績ではなく、提供元間で評価条件は統一していません。 GPQA Diamond 71.2はHF評価欄の値です。AA-LCR 0.72は別指標・別スケールです。LiveCodeBench v6は今回未確認です。 | 評価の出典(新しいタブ) |
「未確認」は資料で今回確認できていない項目です。PT=事前学習版、T=Thinking、5s=5-shot CoT、HF=Hugging Faceの評価欄掲載値。MMLUとMMLU-Pro、SWE-bench ProとVerified、版不明のLCBとLCB v6はそれぞれ別に扱います。
用途から候補を絞るときの見方
【提案】次の分類は試す順番を考えるための候補整理です。日本語の文章品質や、WordPress・SEO業務での適性を検証したランキングではありません。最終的には、同じ依頼文と資料を使って比べてください。

| 試したい作業 | 比較する候補の例 | 手元で確認する点 |
|---|---|---|
| 短い要約・分類 | Gemma 4 E2B / E4B、Qwen3.5-0.8B / 2B / 4B | 指定した形式で返るか、必要な情報を落とさないか |
| 文章と画像を使う作業 | Gemma 4 12B / 26B A4B / 31B、Qwen3.5-9B、Qwen3.6-27B | 使用する配布形式とアプリで画像入力まで使えるか |
| コード修正・開発補助 | Qwen3-Coder-30B-A3B-Instruct、Qwen3-Coder-Next | 差分の正確さ、既存コードへの影響、テスト結果 |
| 推論・問題解決 | DeepSeek-R1-Distill-Qwen-14B / 32B、Qwen3-Next-80B-A3B-Thinking | 結論の根拠、指示への適合、応答にかかる時間 |
小規模なモデルを起点にし、回答が目的を満たすかを確認する進め方を提案します。品質が足りない場合は、依頼文・資料・モデル規模を一つずつ変えると、何が結果に影響したかを追いやすくなります。
M1 Max・64GBを基準に容量欄を読む
量子化表の値は、基準パラメータ数 × 1パラメータ当たりのbit数から求めた重みの理論量です。GBは10進で、小数1桁に四捨五入しています。「27B級」などの概数を使う行もあるため、厳密な配布ファイル容量としては扱いません。
例:30.7B × 4 ÷ 8 = 15.35GB → 小数1桁で15.4GB。
実行時には、量子化のスケール等の補助情報、未量子化の層、画像・音声部、KVキャッシュ、一時領域、実行アプリ、macOSやほかのアプリのメモリも必要です。理論量が64GB未満という理由だけで、動作や快適さを保証することはできません。
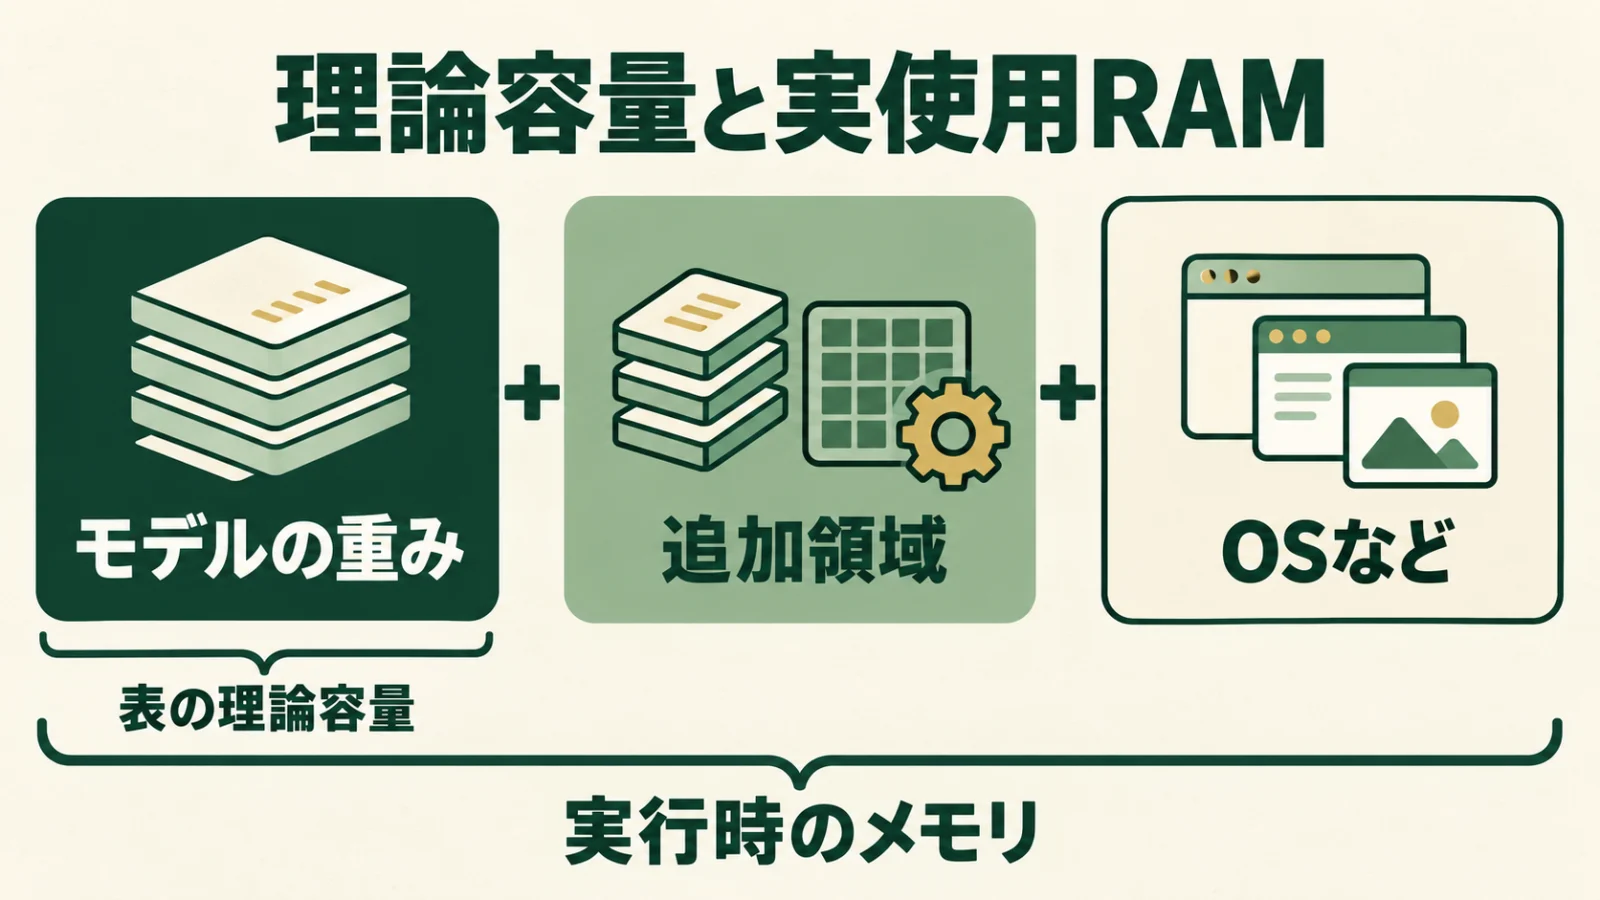
| モデル | 4bitの重み理論量【計算値】 | 64GBを基準にした読み方 |
|---|---|---|
| Gemma 4 12B Unified | 6.0GB | この値に実行時の追加メモリが必要 |
| Gemma 4 31B | 15.4GB | 画像部など、計算対象外の構成も確認 |
| Qwen3-Coder-Next | 40.0GB | 実ファイル容量・文脈長・残りメモリを別に確認 |
| Qwen3.5-122B-A10B | 61.0GB | 64GBに近く、追加領域を含めた動作可否は未検証 |
| Qwen3.8-Flash-Next | 90.0GB | 計算対象の重み全体を64GBに常駐させる前提では容量を超える |
MoEの「稼働パラメータ」と総量を区別する
MoEモデルの「稼働3B」「稼働6B」は、推論時に使う一部のパラメータを示す表記です。モデル全体の重みや必要RAMが、その数字と同じになるわけではありません。総パラメータ数と、埋め込み・画像部・MTPなどの構成を合わせて確認します。
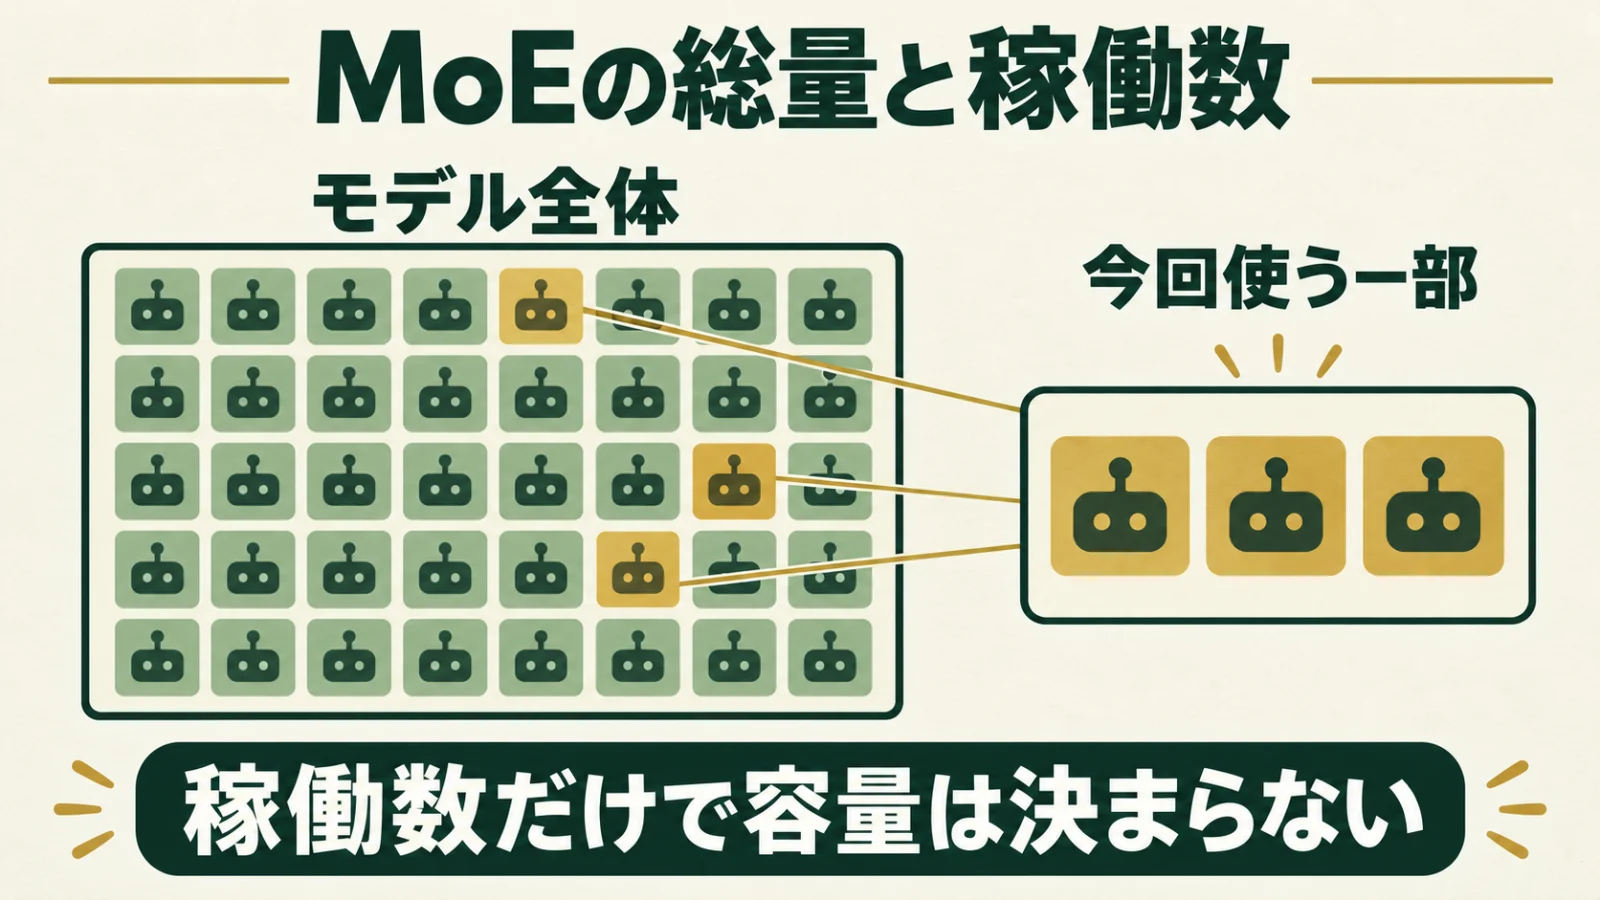
No.08のQwen3.8-Flash-Nextは、公式表記の125Bに、埋め込み51BとMTP4Bが別途あります。本表では合計180Bを基準に計算しており、稼働6Bで計算していません。No.20のQwen3-Next-80B-A3B-Thinking、No.21のQwen3-Coder-Nextとは別モデルです。Qwen公式モデルカード
公式のメモリ概算も参考にする
GoogleはGemma 4について、GPU・TPUへの読み込み概算を公開しています。以下は重み理論量の表と別の値です。読み込み追加分20%を考慮した概算で、KVキャッシュや補助ソフトの領域は別途必要です。Google公式のメモリ概算
| Gemma 4 | BF16 | SFP8 | Q4_0 |
|---|---|---|---|
| E2B | 11.4GB | 5.7GB | 2.9GB |
| E4B | 17.9GB | 8.9GB | 4.5GB |
| 12B | 26.7GB | 13.4GB | 6.7GB |
| 26B A4B | 57.7GB | 28.8GB | 14.4GB |
| 31B | 69.9GB | 34.9GB | 17.5GB |
公開ベンチマークは評価名と条件をそろえて読む
比較表のGPQA Diamondは科学的推論、LiveCodeBench v6はコード課題の公開評価です。ただし、提供元ごとの設定・評価モード・ハーネスは統一されていません。スコアは候補を調べる手掛かりとして使い、Macでの速度や日本語の書きやすさへ直接置き換えないようにします。
- 評価名と版:MMLUとMMLU-Pro、LiveCodeBenchの版不明値とv6を分けて読む。
- モデルの種類:Gemma 2のPT版と、対話・指示調整版を混ぜない。Thinking条件も確認する。
- 測り方:Mistral Small 3.2のGPQA Diamond・MMLU-Proは5-shot CoT条件。Llama 4 Scoutは公式本文のGPQA値を掲載し、HF評価欄の別結果と区別する。
- コード評価:SWE-bench ProとVerifiedは別指標。Qwen3.8のSWE-Proには提供元による再評価条件がある。
- 未確認:空欄を0点として扱わない。本表では未確認と表示し、無理に順位づけしない。
【未検証】掲載した公開スコアは、各量子化版の品質や日本語・WordPress・SEO実務の優劣を証明するものではありません。使う候補が決まったら、同じ依頼文・入力資料・採点基準で実務に近い出力を比べます。
M1 Max・64GBでの外部検証報告を見る
参考として、M1 Max・64GBでQwen3-Coder-Nextの量子化版を比べた外部投稿があります。以下はその投稿に掲載された数値です。当サイトによる実測ではなく、再現検証は【未検証】です。投稿者の比較条件と結果を確認する
| 量子化方式 | 投稿のSize欄(GB) | 平均合格率 | 生成速度(tok/s) |
|---|---|---|---|
| MLX 3bit | 34.90 | 60.4% | 23.4 |
| MLX 4bit | 44.86 | 63.3% | 24.8 |
| GGUF UD-IQ3_XXS | 32.71 | 61.3% | 23.66 |
| GGUF Q4_K_M | 48.73 | 61.7% | 19.93 |
投稿は各1回・128問の比較で、LiveBench codingの2024-11-25版を使用しています。上の24モデル表のLiveCodeBench v6とは別評価です。平均合格率は投稿内の2課題の合格率を平均した値で、Size欄も実使用RAMとは区別して読んでください。
実行環境はllama.cpp f93c09e26とoMLX 0.3.0です。この一例から、MLXとGGUFの優劣や全モデルの速度を一般化せず、自分の環境で試す際の比較条件の参考にします。
試す前に確認する5項目
- 配布ファイル:公式モデル名・派生版・量子化方式を確認する。同じ4bitでもGGUFやMLXなどでファイル容量と実行条件が変わる。
- 実行アプリ:使用するMac、アプリ、モデル構造が対応しているかを確認する。画像・音声・動画入力もアプリ側の対応を確認する。
- 余裕のある条件:短い入力と控えめなコンテキストから試し、実使用RAM、応答時間、出力品質を記録する。
- 利用条件:各行の公式配布元とライセンスを確認する。Apache 2.0、MIT、Gemma規約、Llama 4規約、Qwen Community 1.0を一括して扱わない。
- 資料と処理先:顧客情報などを入力する前に、保存先・外部接続・クラウド機能の設定を確認する。
No.11のMistral Medium 3は、一般公開重みとパラメータ数が確認できていない参考項目です。公式ページでは非推奨と案内されています。全24件を「Macでローカル実行できるモデル」として一括して選ばず、配布条件を確認した候補から試してください。Mistral公式資料
導入環境やアプリの選び方から確認したい方は、MacでローカルAIを始める手順と、LM Studio・MLX・メモリの考え方もあわせてご覧ください。
よくある質問
4bitの理論容量が64GB未満なら、64GBのMacで動きますか?
理論容量だけでは判断できません。量子化の補助情報、KVキャッシュ、画像・音声部、実行環境、macOSなどにもメモリが必要です。配布ファイルと実行エンジンの対応を確認し、短い入力から実使用RAMと動作を確かめてください。
MoEの「稼働3B」「稼働6B」はモデル全体の規模ですか?
モデル全体の規模ではありません。稼働パラメータ数は処理時に使う一部を示します。重みの容量を考える際は総数や埋め込みなどの構成も確認します。本表のMoE容量は、資料に記載された総数を基準にした概算です。
公開ベンチマークが高ければ、日本語の記事制作にも向いていますか?
公開スコアだけで実務品質は確定できません。日本語の自然さ、出典への忠実さ、指示への従い方などは、同じ課題を各候補に渡して確認してください。この比較では日本語・WordPress・SEO実務の優劣を実測していません。
24モデルはすべてMacで動作確認済みですか?
全24モデルのMac実機検証は行っていません。公開仕様と提供資料の比較であり、一般公開重みが未確認の参考項目も含みます。外部のM1 Max検証報告は出典と条件を分けて掲載しています。
候補を選んだら、同じ課題で比べる
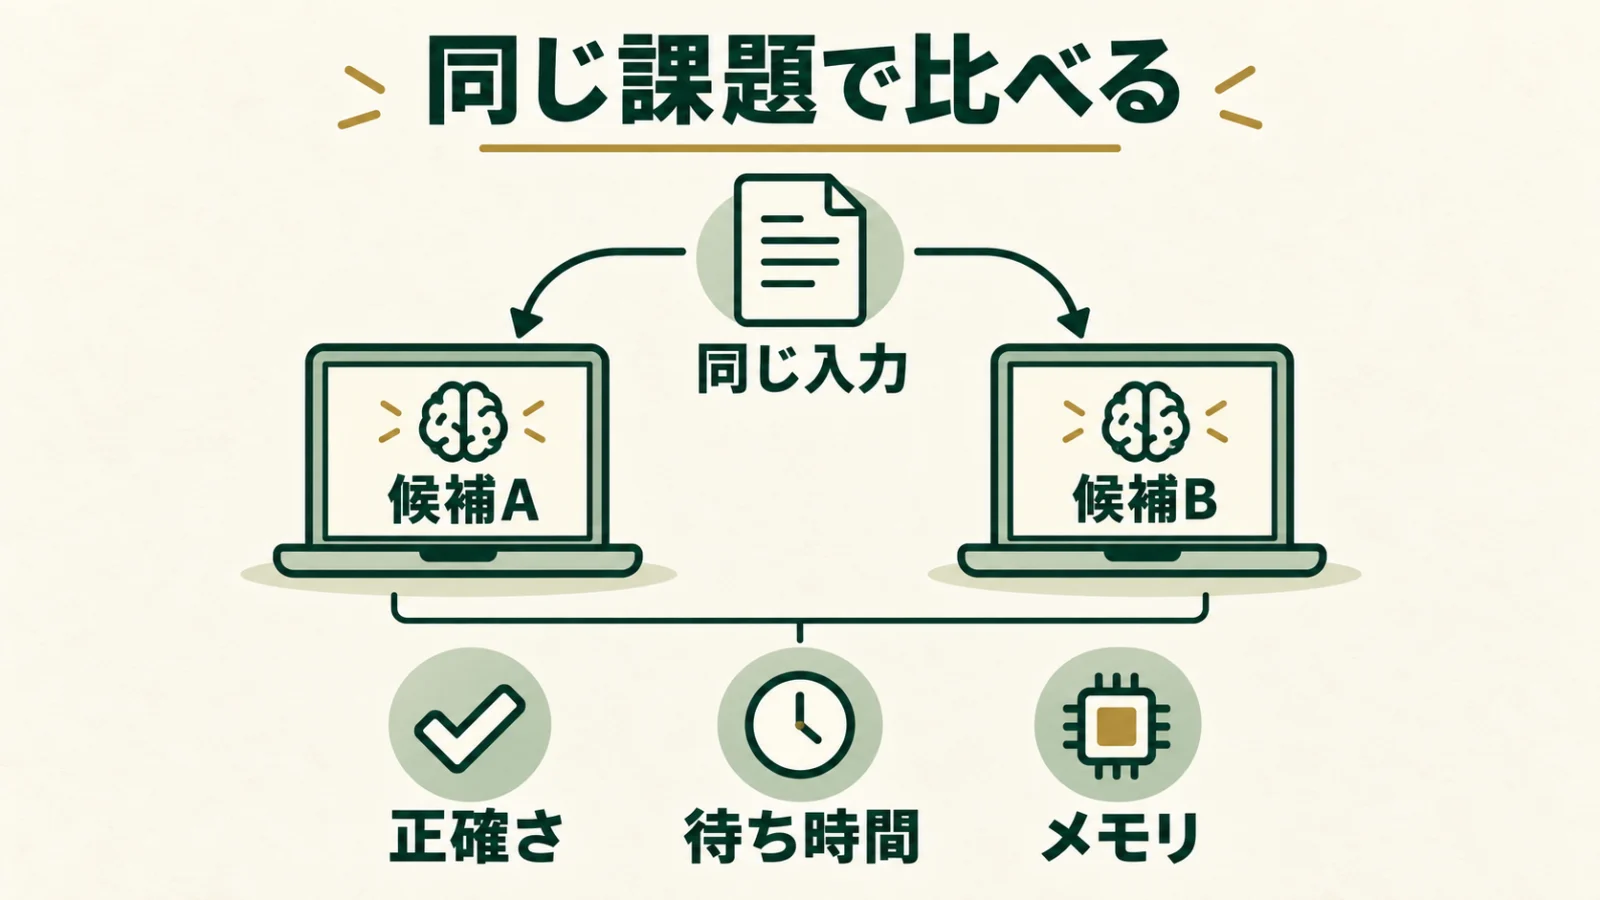
まずは比較表から、目的・対応入力・重みの規模が合う候補を選びます。その後、実際に使うアプリと配布形式を確認し、同じ課題で出力を比べましょう。公開スコアと、手元で確認できた結果を分けて残すことが、次のモデル選びにも役立ちます。
比較資料と出典について
基礎資料は「ローカルLLM24モデル比較表_量子化とベンチマーク.pdf」と記事制作メモです。提供された比較表PDFを保持し、全24件の番号と比較データを記事内へ収録しました。元の11件・追加13件という資料上の区分も、PDF No.01–11・No.12–24で確認できます。
モデル仕様・ライセンス表示・掲載スコアは、比較表のモデル名と「評価の出典」から一次資料を開けます。No.06とNo.20の評価リンクは、対象モデルの列を含む別モデルの公式比較表です。Gemma 2の8,192トークンはGoogleの技術論文でも確認できます。
補助資料:Google公式のGemma 4メモリ概算、M1 Max・64GBでの外部量子化比較投稿。仕様確認と実機検証は区別しており、全モデルの配布形式・実行エンジン対応・実務品質を検証した記事ではありません。